Как они работают на самом деле — от сбора данных до цепочки мыслей
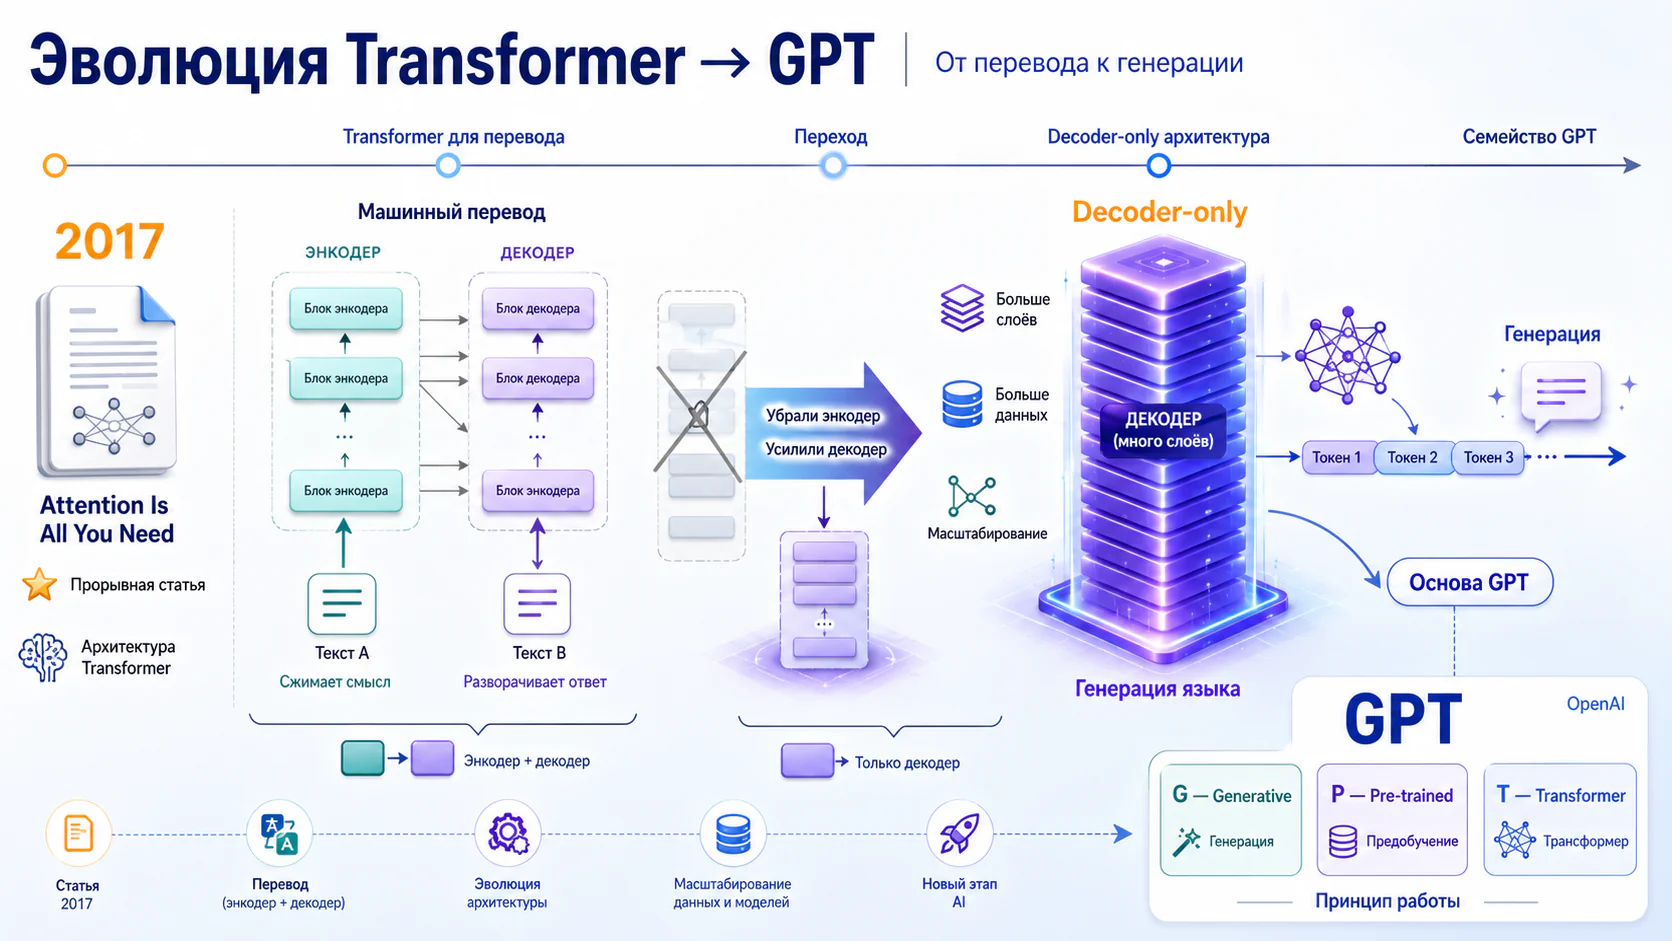
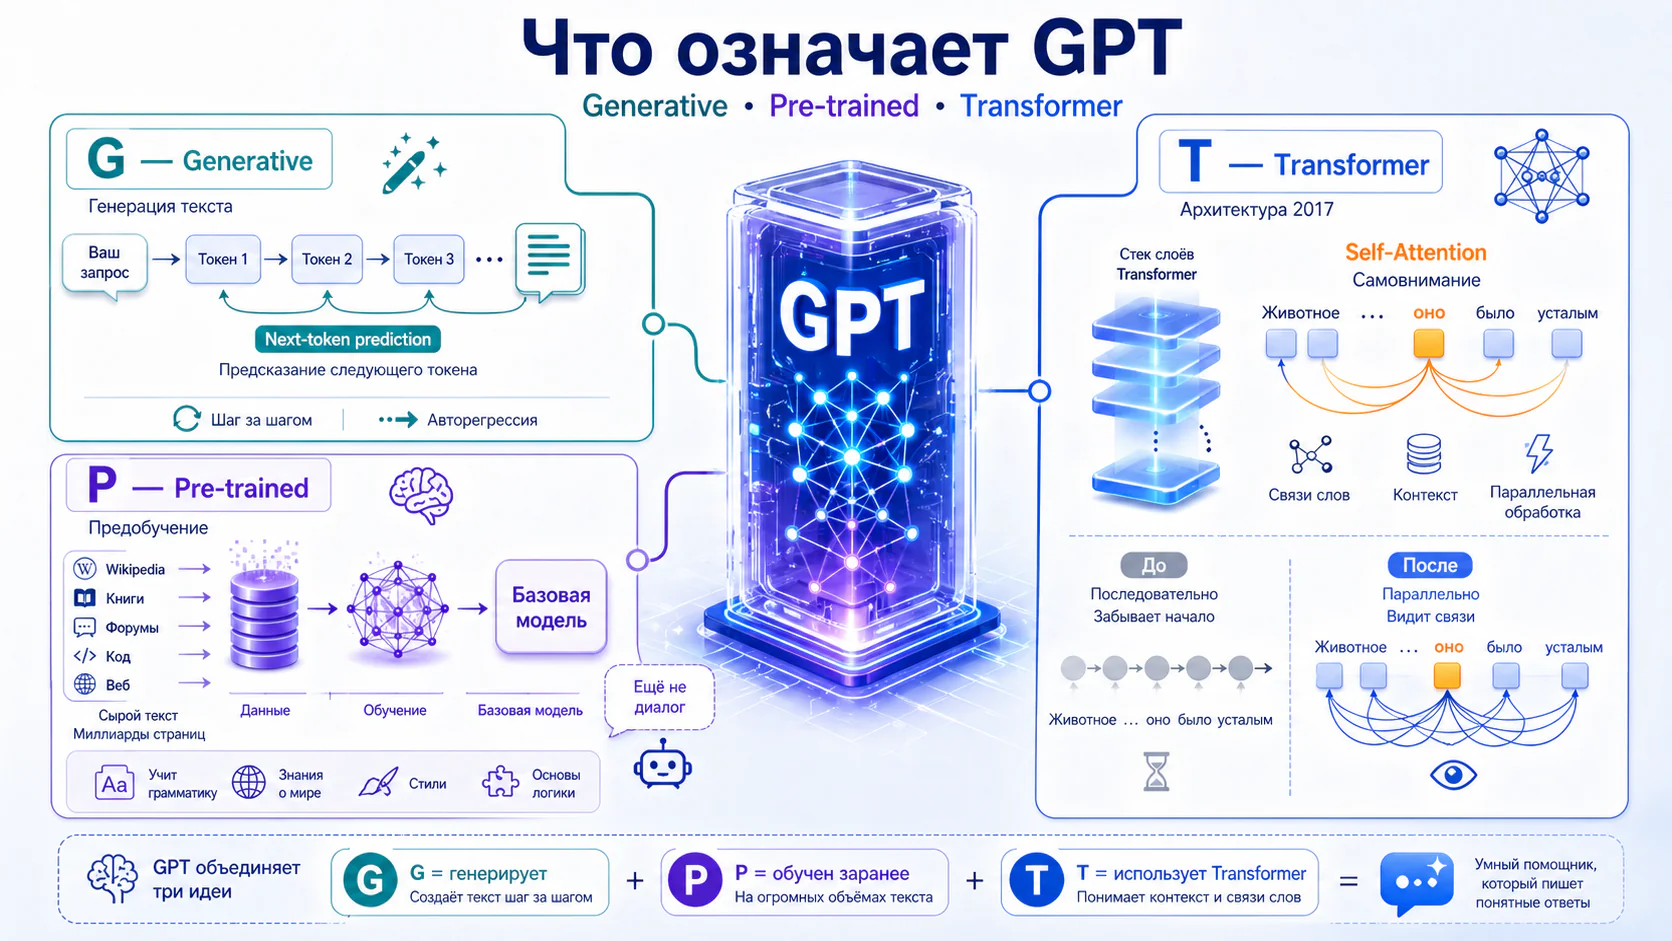
G — Generative · P — Pre-trained · T — Transformer
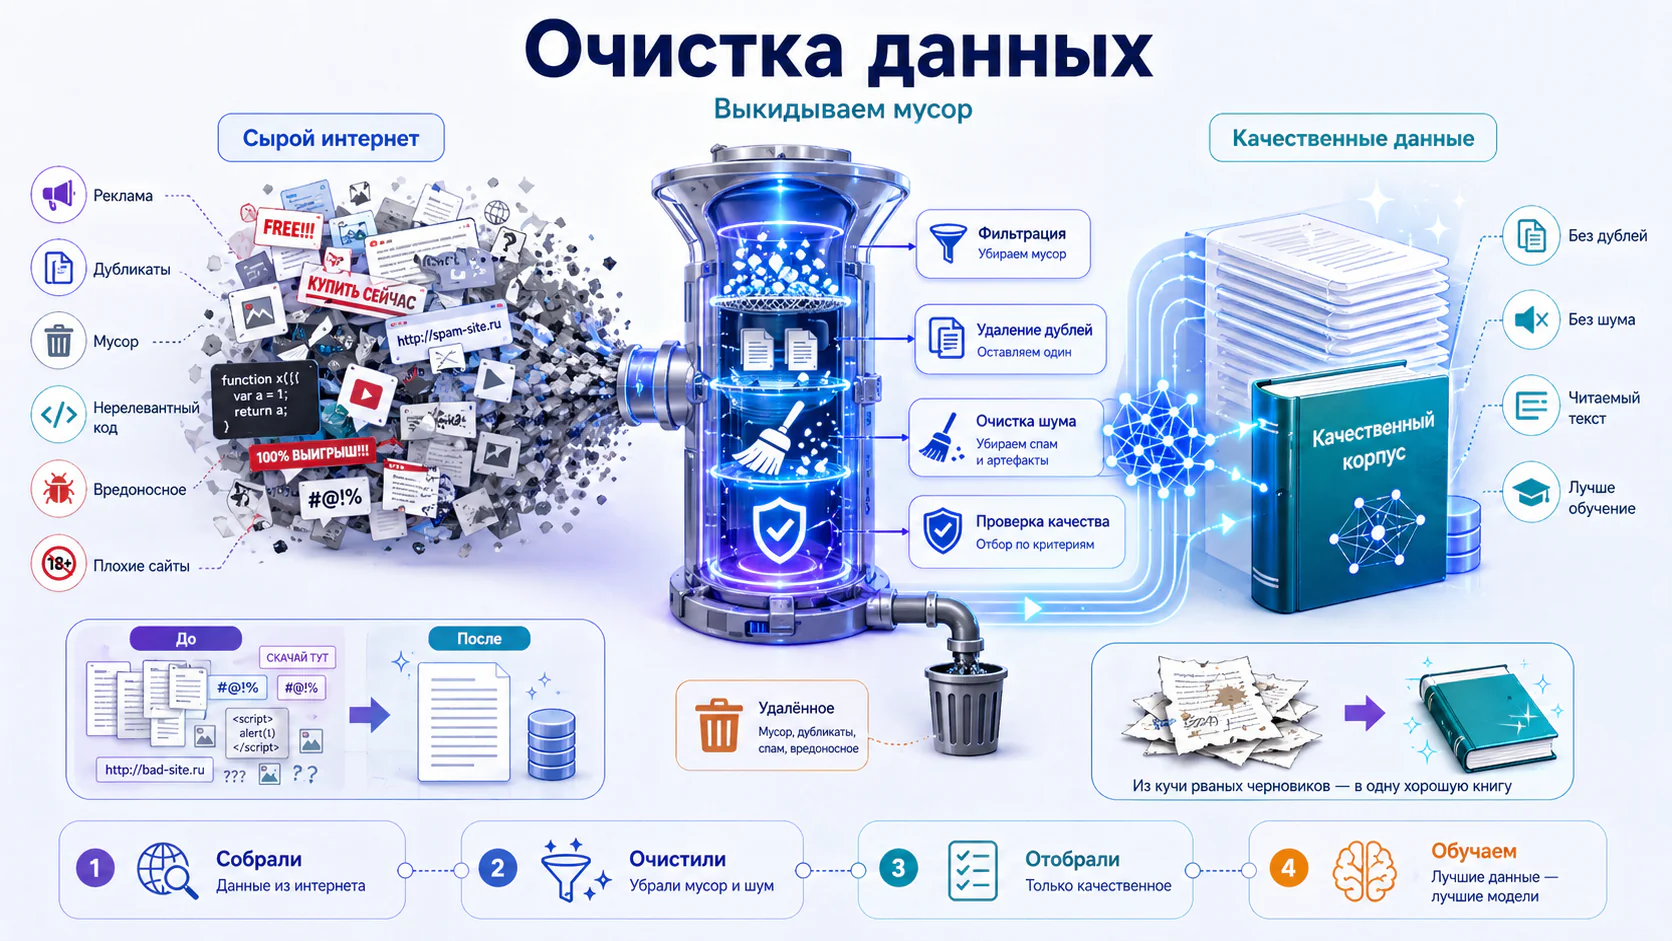
Краулеры собирают триллионы токенов. Очистка удаляет мусор и дубликаты. Доминирование английского языка формирует «англоязычный акцент» ИИ навсегда.
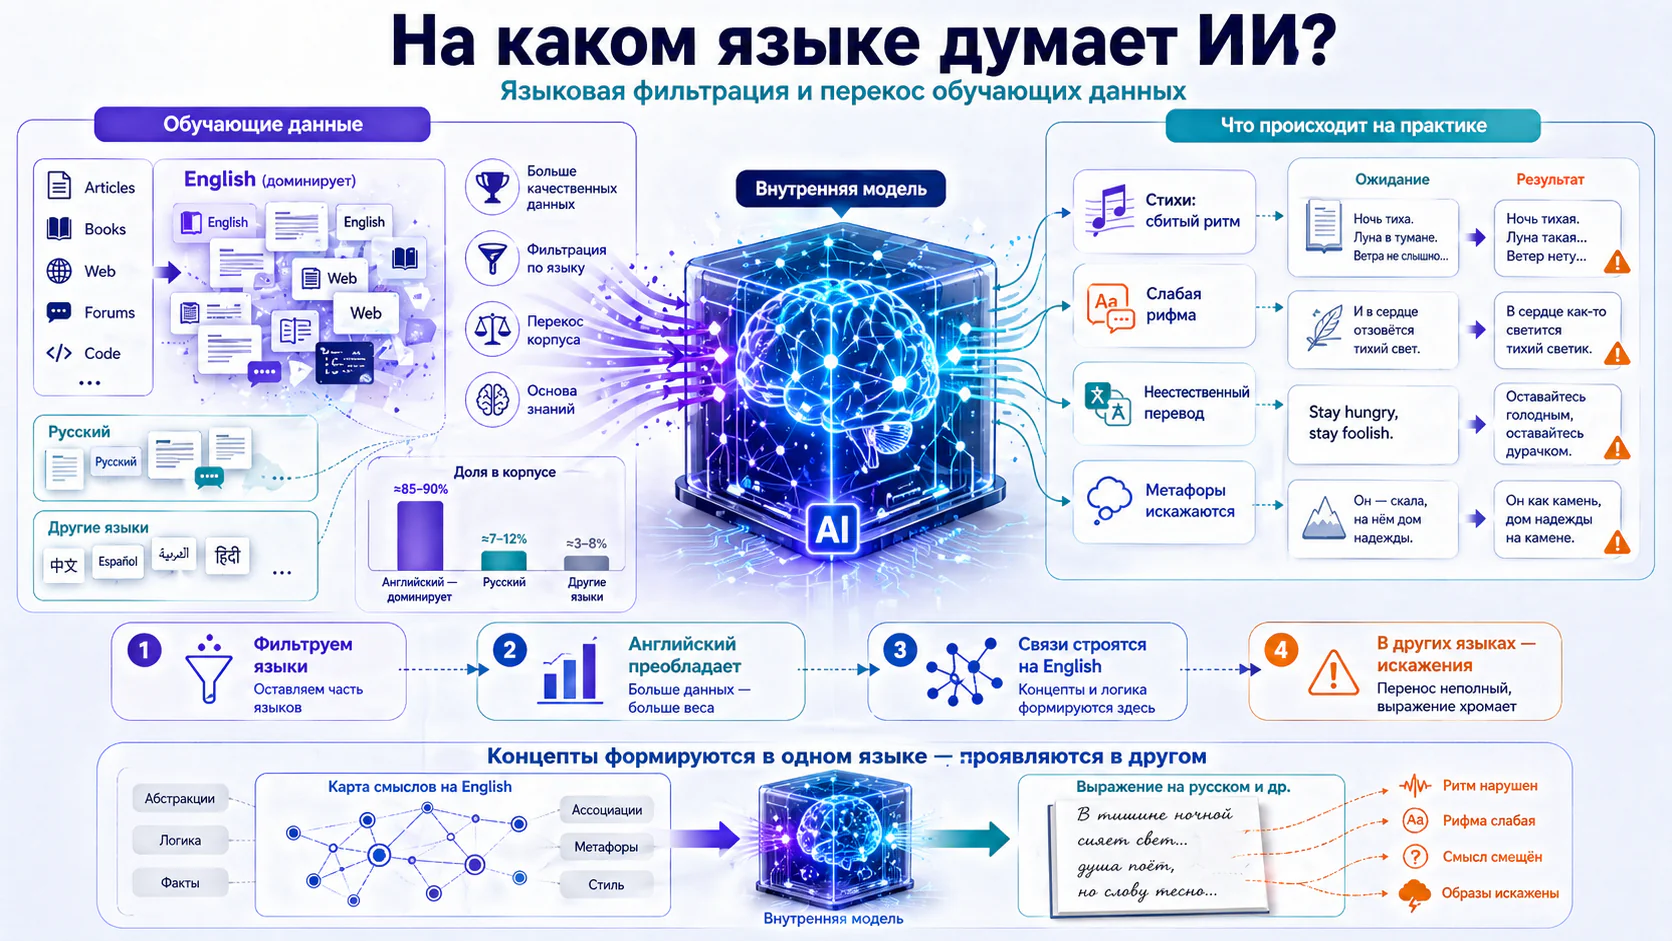
Нейросети работают только с числами. BPE находит самые частые пары символов и объединяет их. Модель предсказывает не слово, а следующий токен.
Каждое слово — точка в пространстве из тысяч измерений. Контекстуальные эмбеддинги меняют координаты «на лету», учитывая соседей — так модель различает омонимы.
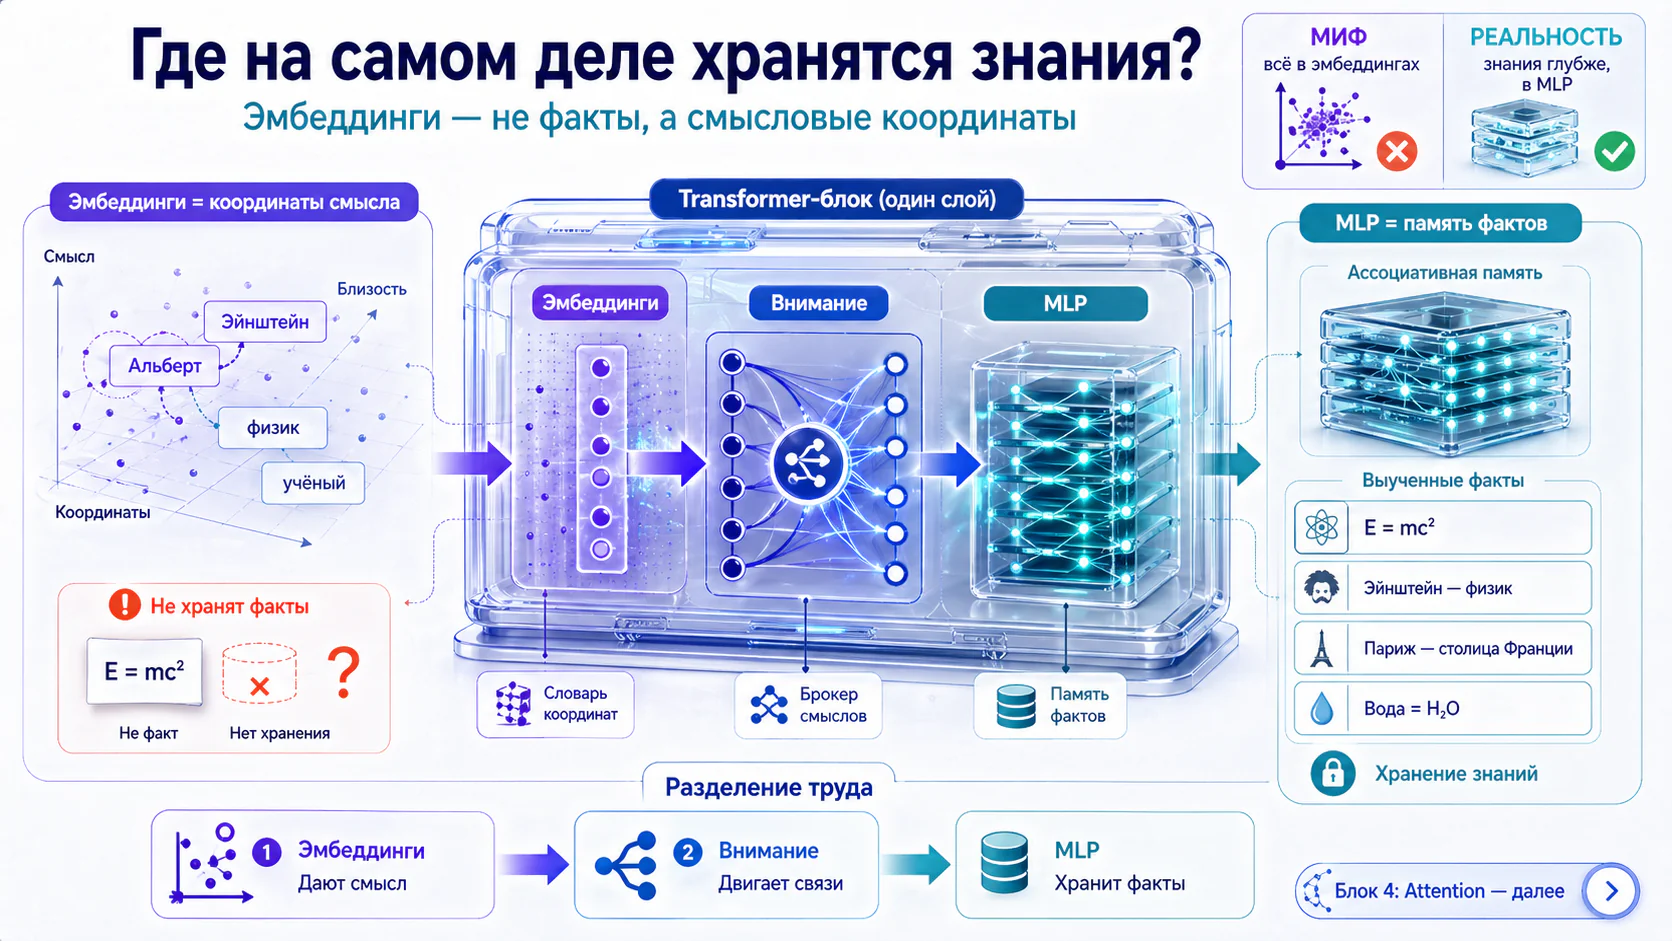
Self-Attention позволяет каждому слову «видеть» все остальные. MLP-слои хранят выученные факты. 12 голов внимания работают параллельно, каждая со своей специализацией.
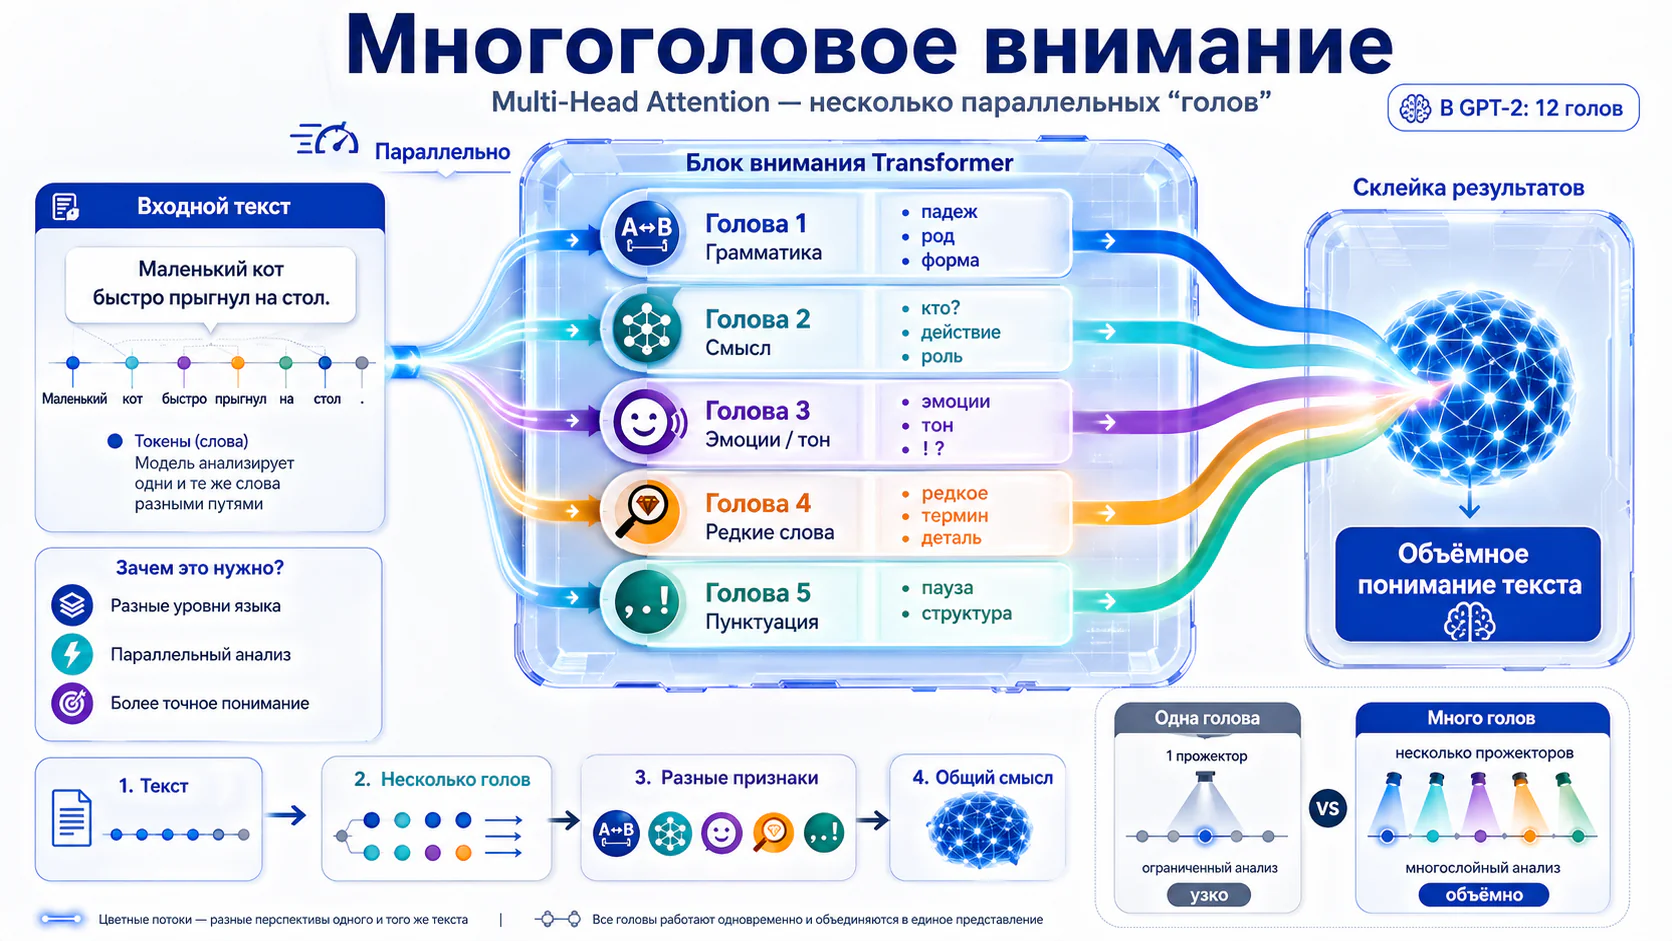
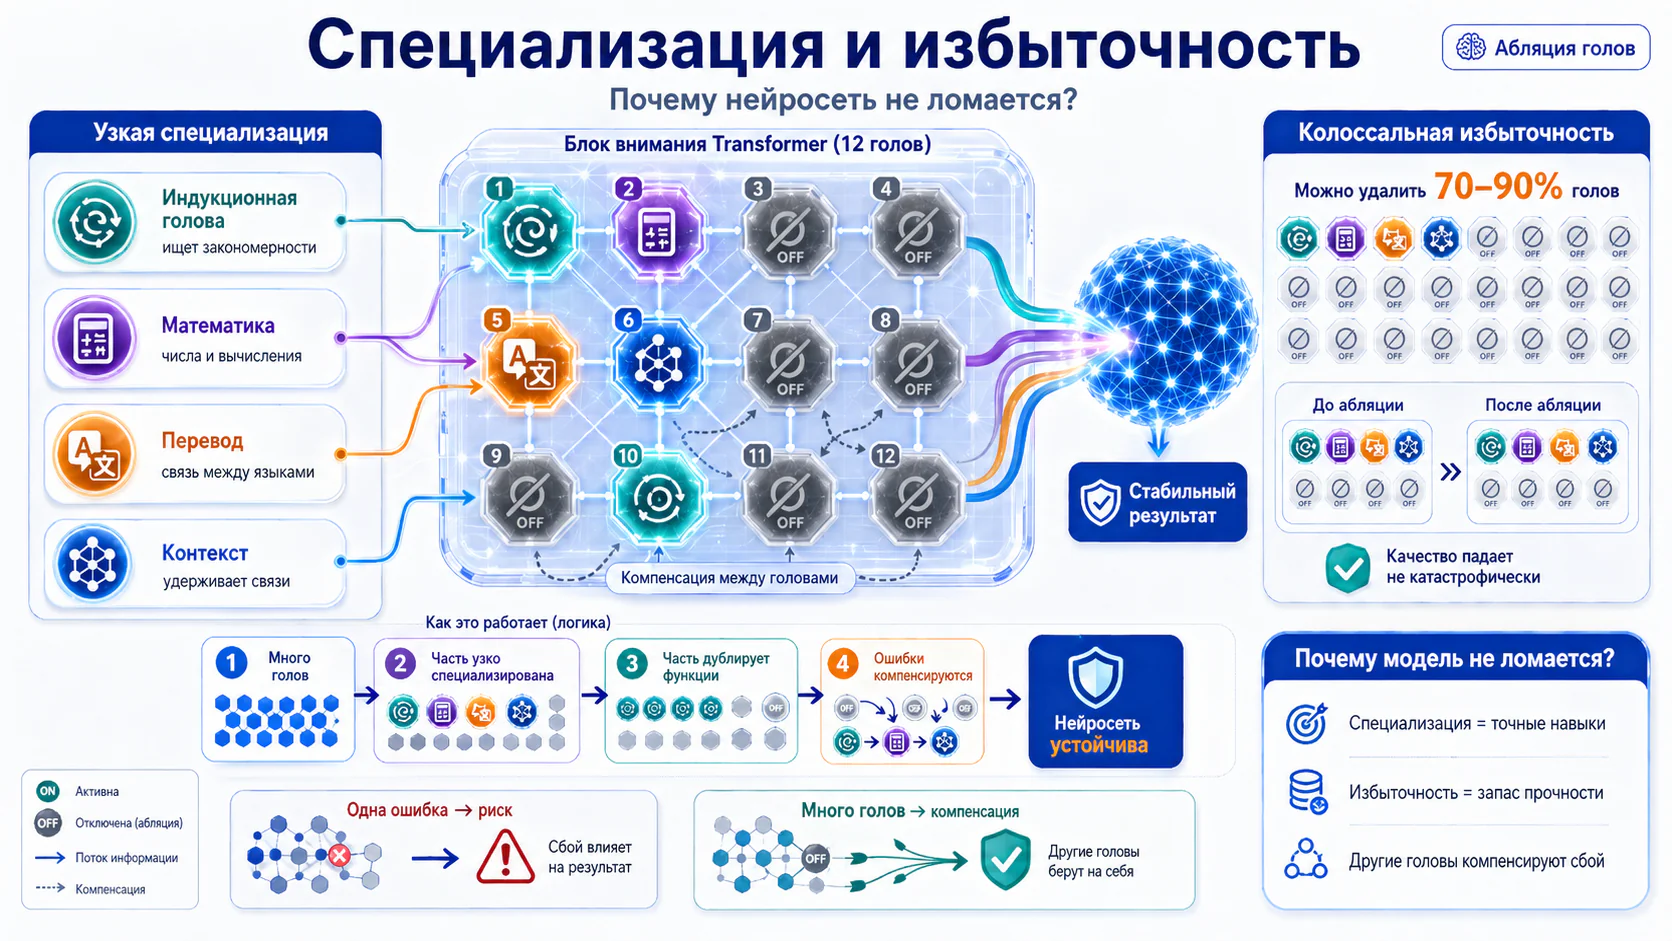
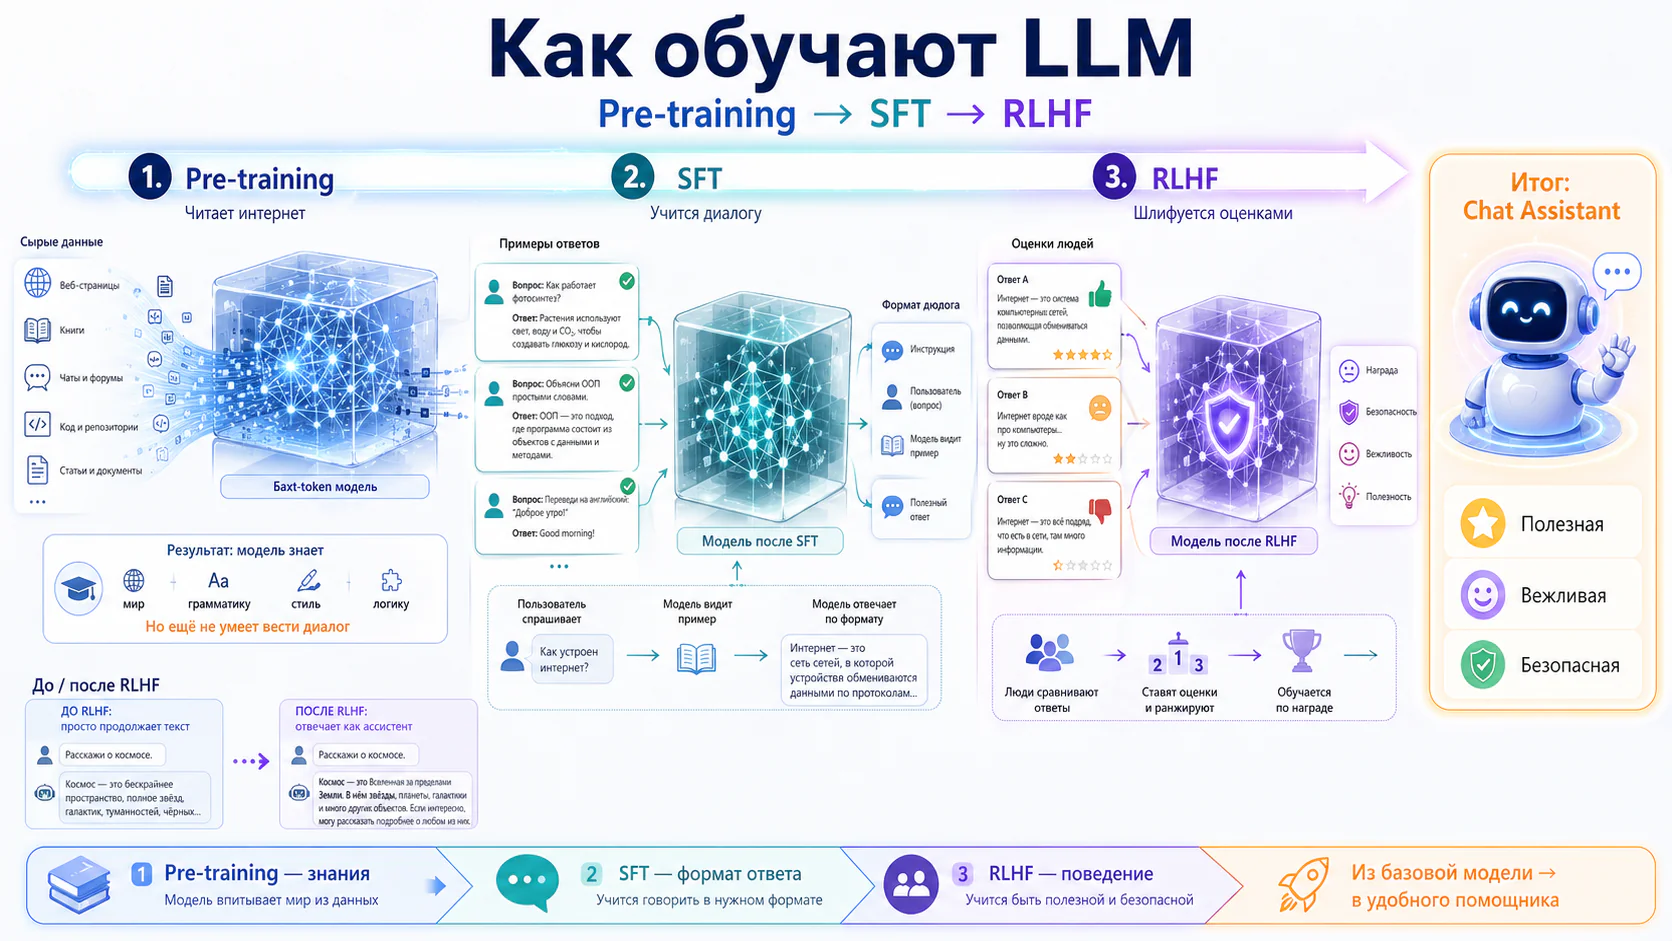
Pre-training: чтение всего интернета — предсказание следующего токена. SFT: тонкая настройка на примерах диалогов. RLHF: оценки людей «выравнивают» модель под человеческие ценности.
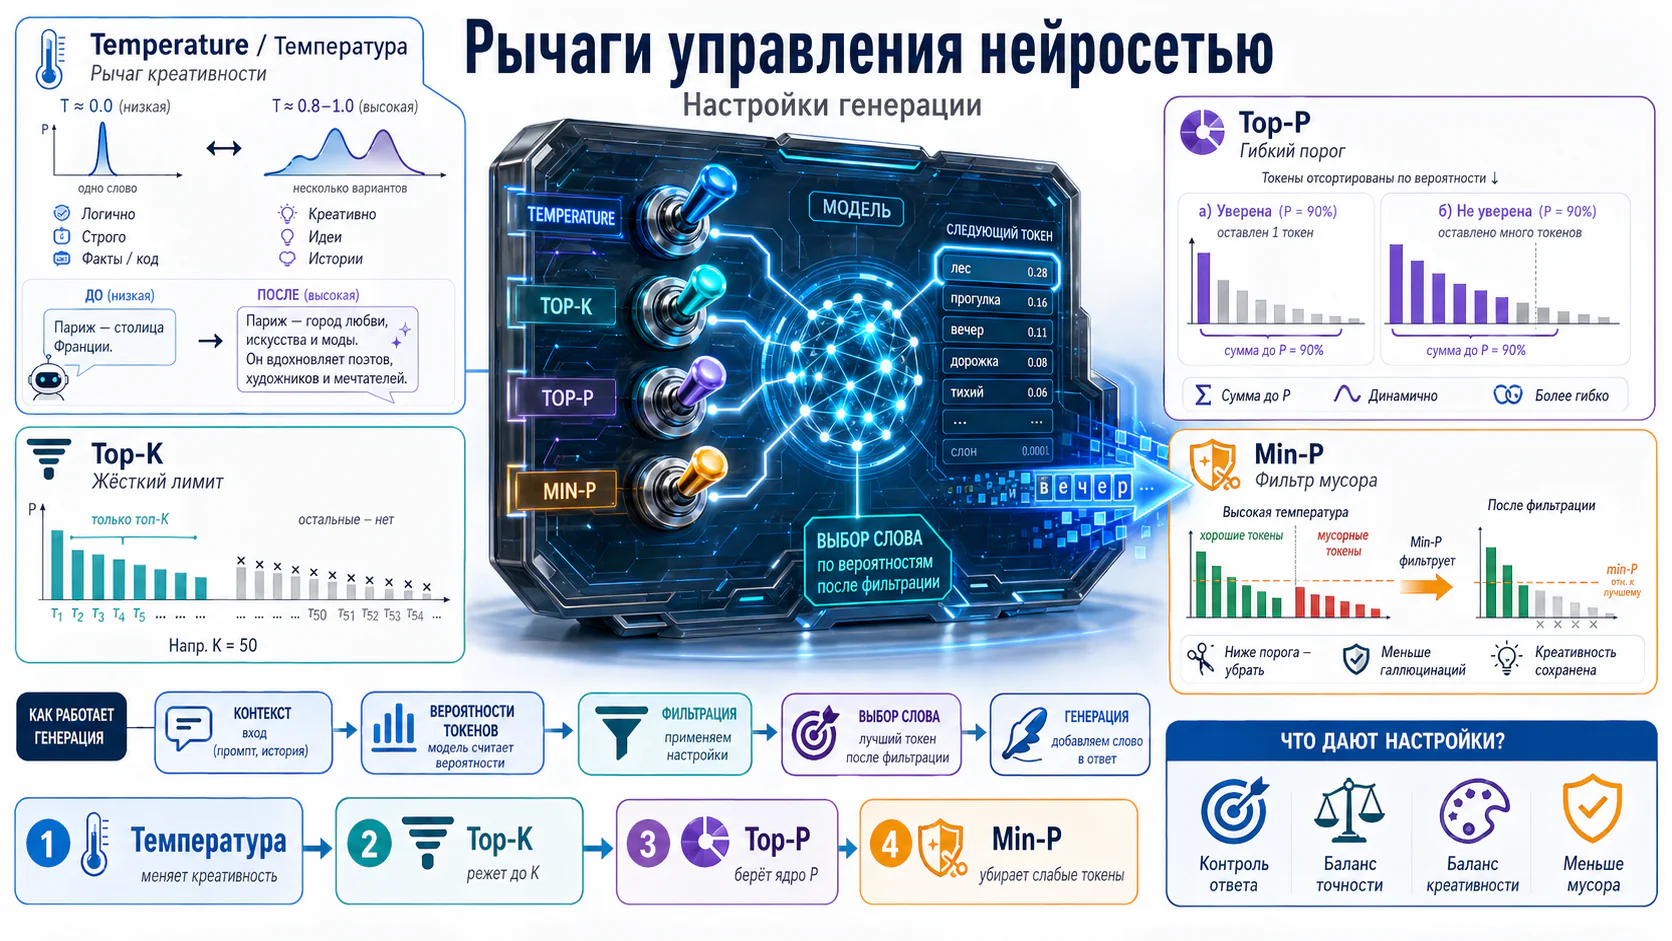
Каждый ответ — статистический бросок кубика со 100 000 гранями. Температура, Top-K, Top-P и Min-P задают баланс точности и креативности.
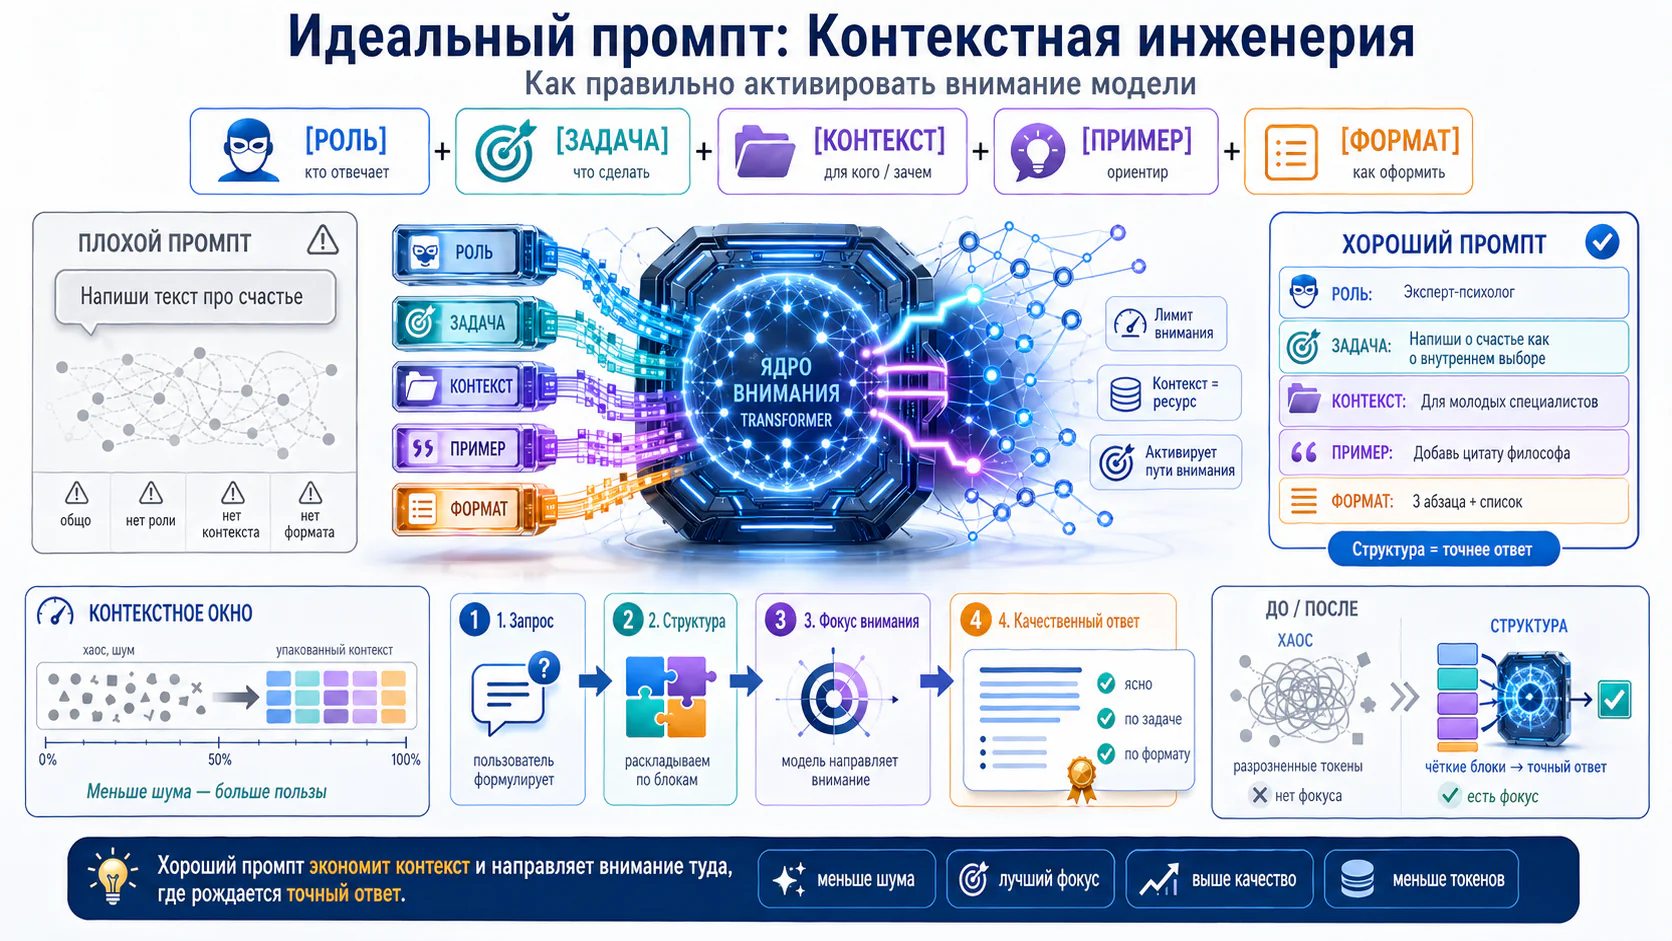
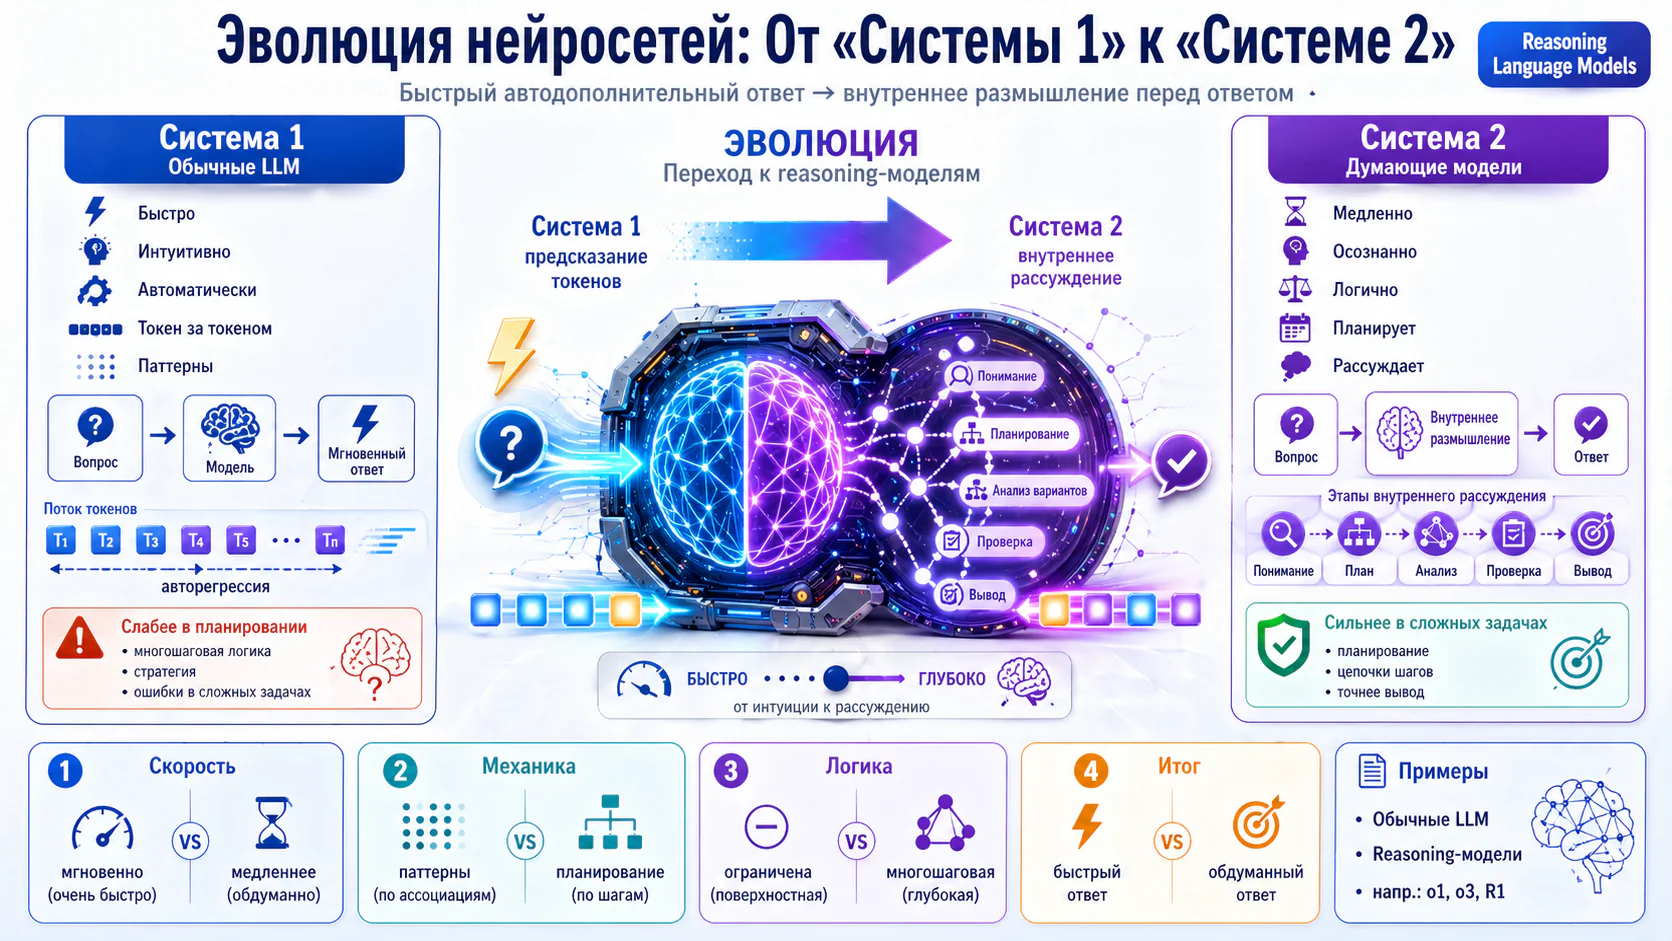
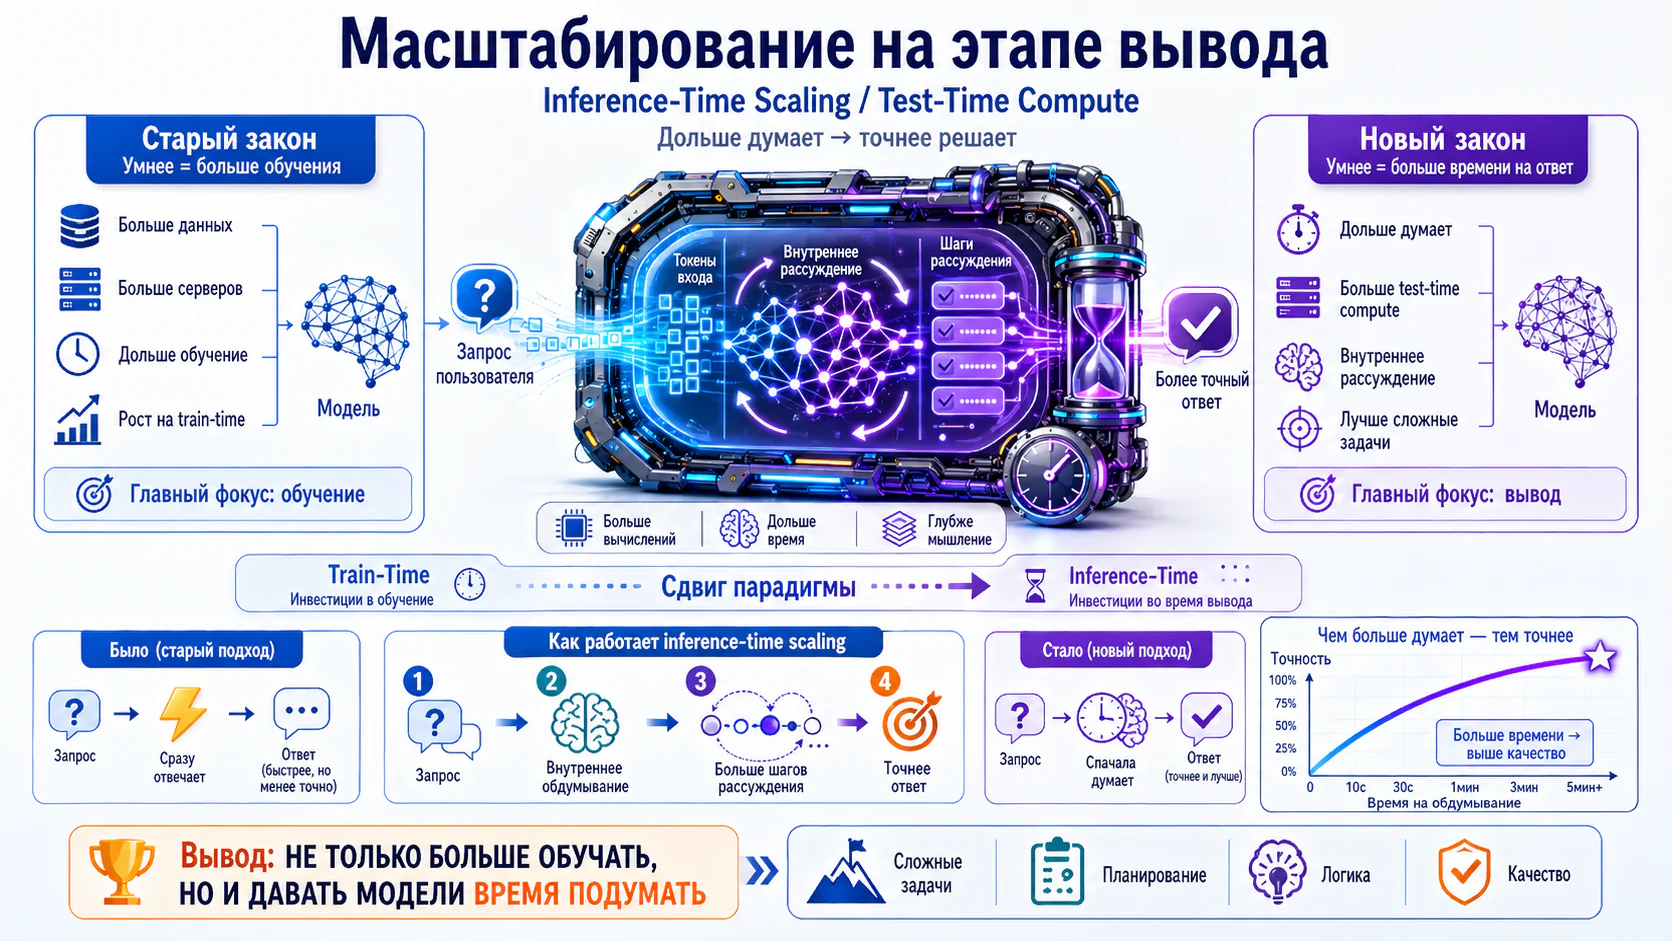
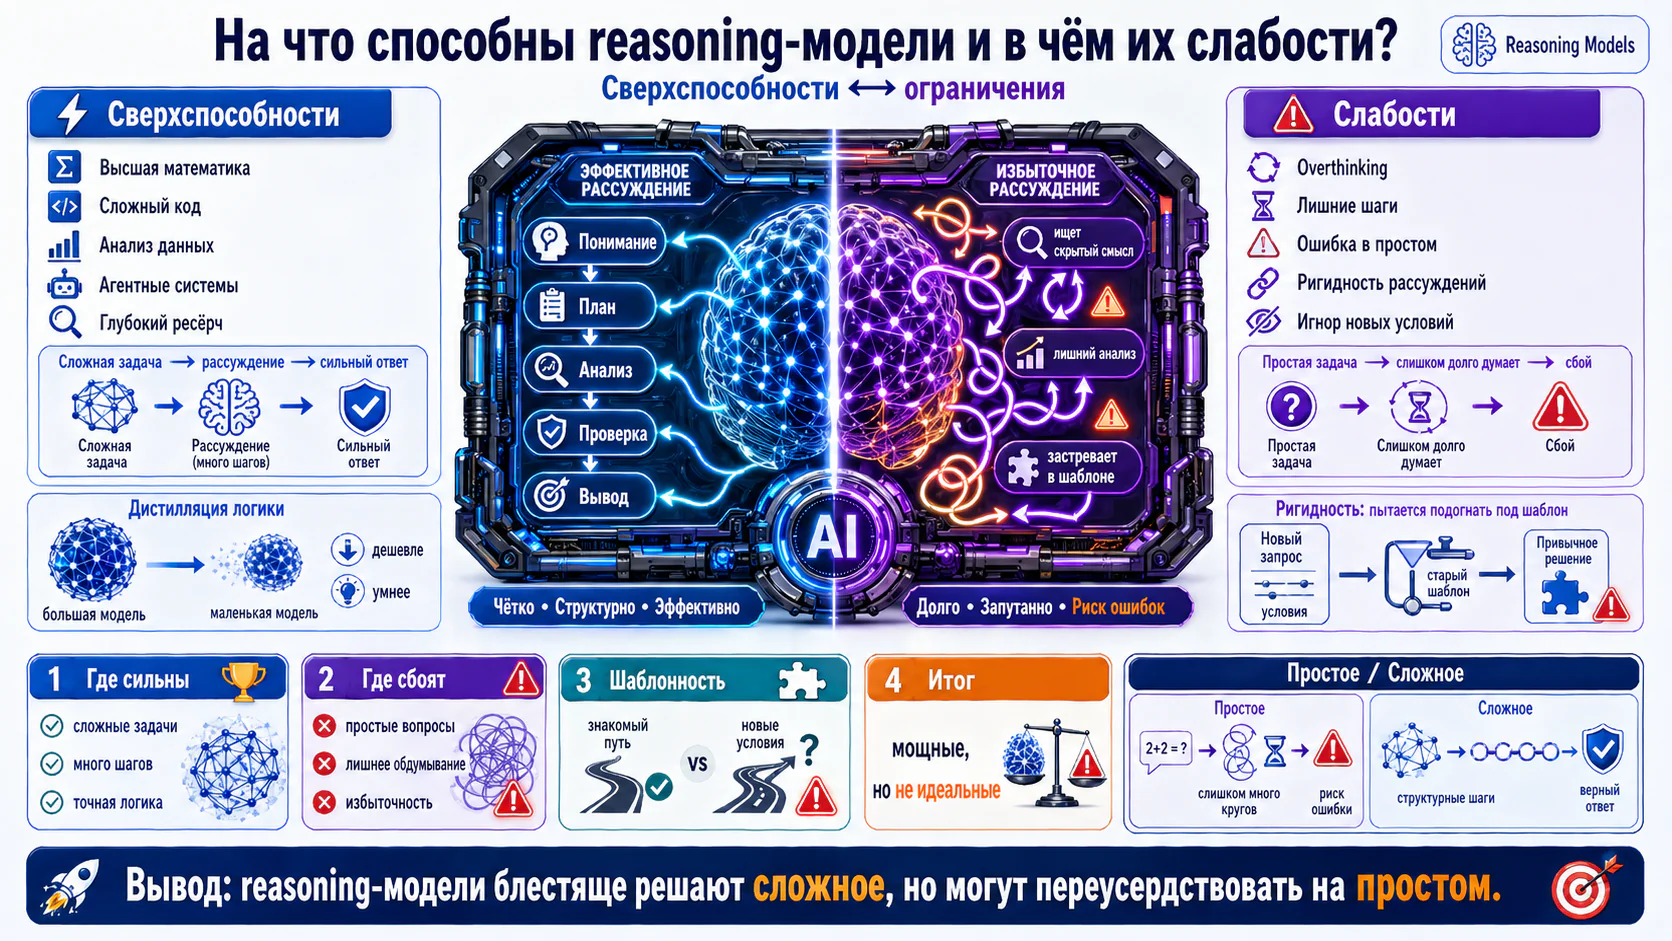
От «Системы 1» (мгновенный рефлекс) к «Системе 2» (медленное обдумывание). Reasoning-модели тратят вычислительные ресурсы на рассуждение, самопроверку и поиск ошибок прежде чем ответить.